Wave: da dati di prodotto a miglioramenti spediti
Wave è l’agente proattivo di Amplitude. Le squadre indicano un’area di prodotto e gli obiettivi o metriche da migliorare; Wave raccoglie dati di Amplitude, replay di sessione, feedback dei clienti e codice sorgente per identificare, priorizzare e sviluppare soluzioni. Il flusso termina con la consegna a agenti di codifica, come Codex, e il monitoraggio dell’impatto, creando un ciclo di apprendimento continuo.
Dietro il workflow, Amplitude impiega diversi modelli OpenAI a seconda del compito. GPT‑6.1 Sol gestisce la gestione delle opportunità e le indagini profonde su codice e dati. GPT‑6 Luna si occupa di compiti frequenti e a basso costo, come la scansione di codice e piccoli controlli di valutazione. GPT‑Image‑2.5 Flare genera mock‑up di prodotto usando screenshot dei replay come riferimento visivo.
Quando un’opportunità è pronta per essere costruita, le squadre la inviano direttamente da Wave agli agenti di codifica, includendo un piano tecnico e criteri di accettazione per guidare l’implementazione.
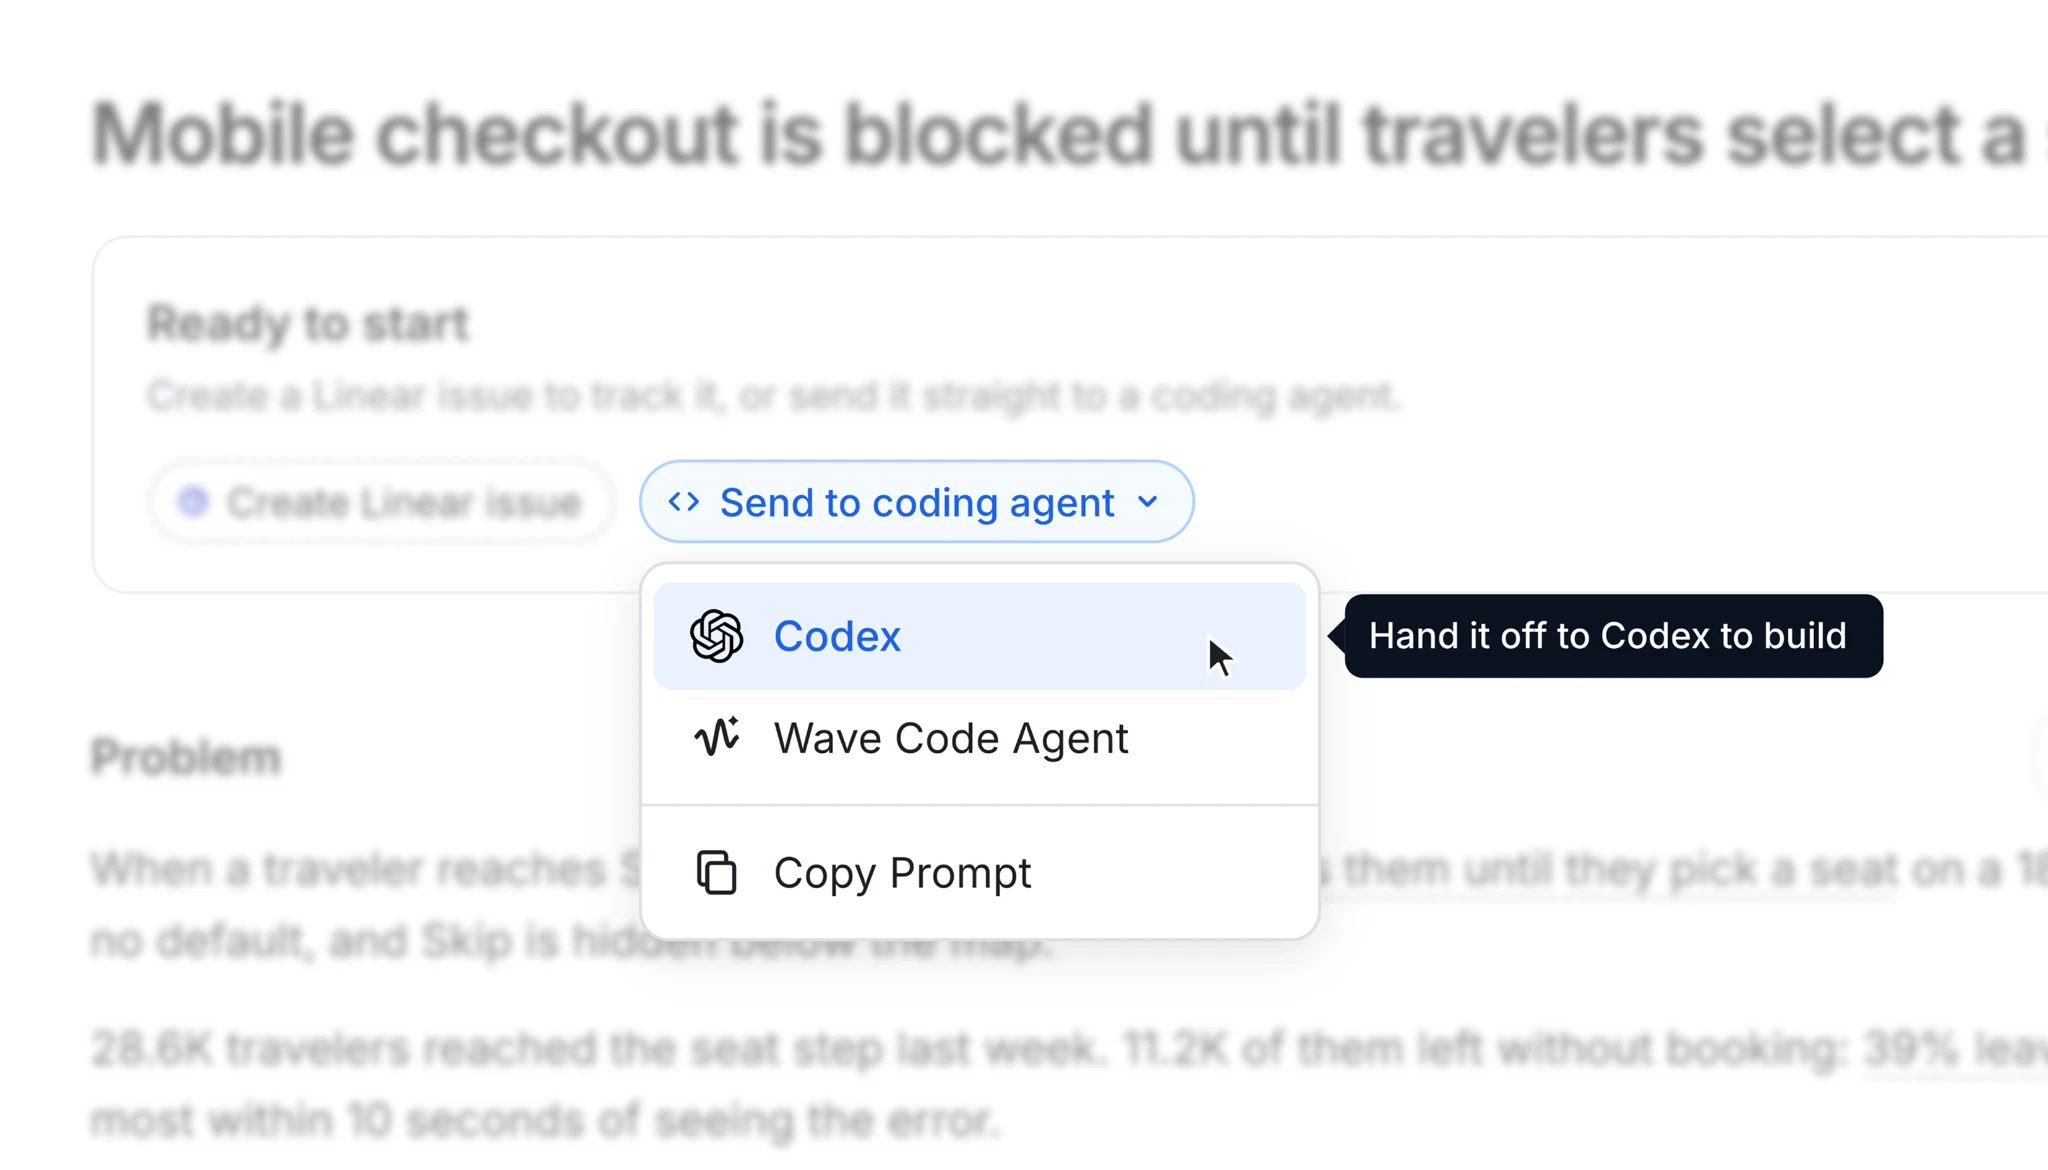
Un caso reale: +160 % di engagement sugli agenti
Jacob Newman, Principal AI Product Manager di Amplitude, spiega: “L’idea di Wave è avere una piattaforma unificata con agenti che setacciano enormi quantità di replay, analytics e codice per trovare opportunità di miglioramento.”
Amplitude ha testato Wave sulla propria homepage, dove le schede di suggerimento generiche dovevano avviare conversazioni con un agente AI. L’analisi di 100 replay ha mostrato che 80 utenti digitavano domande proprie, mentre solo 12 selezionavano una scheda.
Wave ha suggerito di personalizzare le schede usando grafici recenti, dashboard o la pagina di provenienza dell’utente. Ha illustrato il cambiamento, prodotto un piano tecnico (preservare la digitazione libera e mostrare suggerimenti generici se il contesto di personalizzazione è assente) e, dopo una breve revisione, ha affidato il lavoro a un agente di codifica per un test A/B.
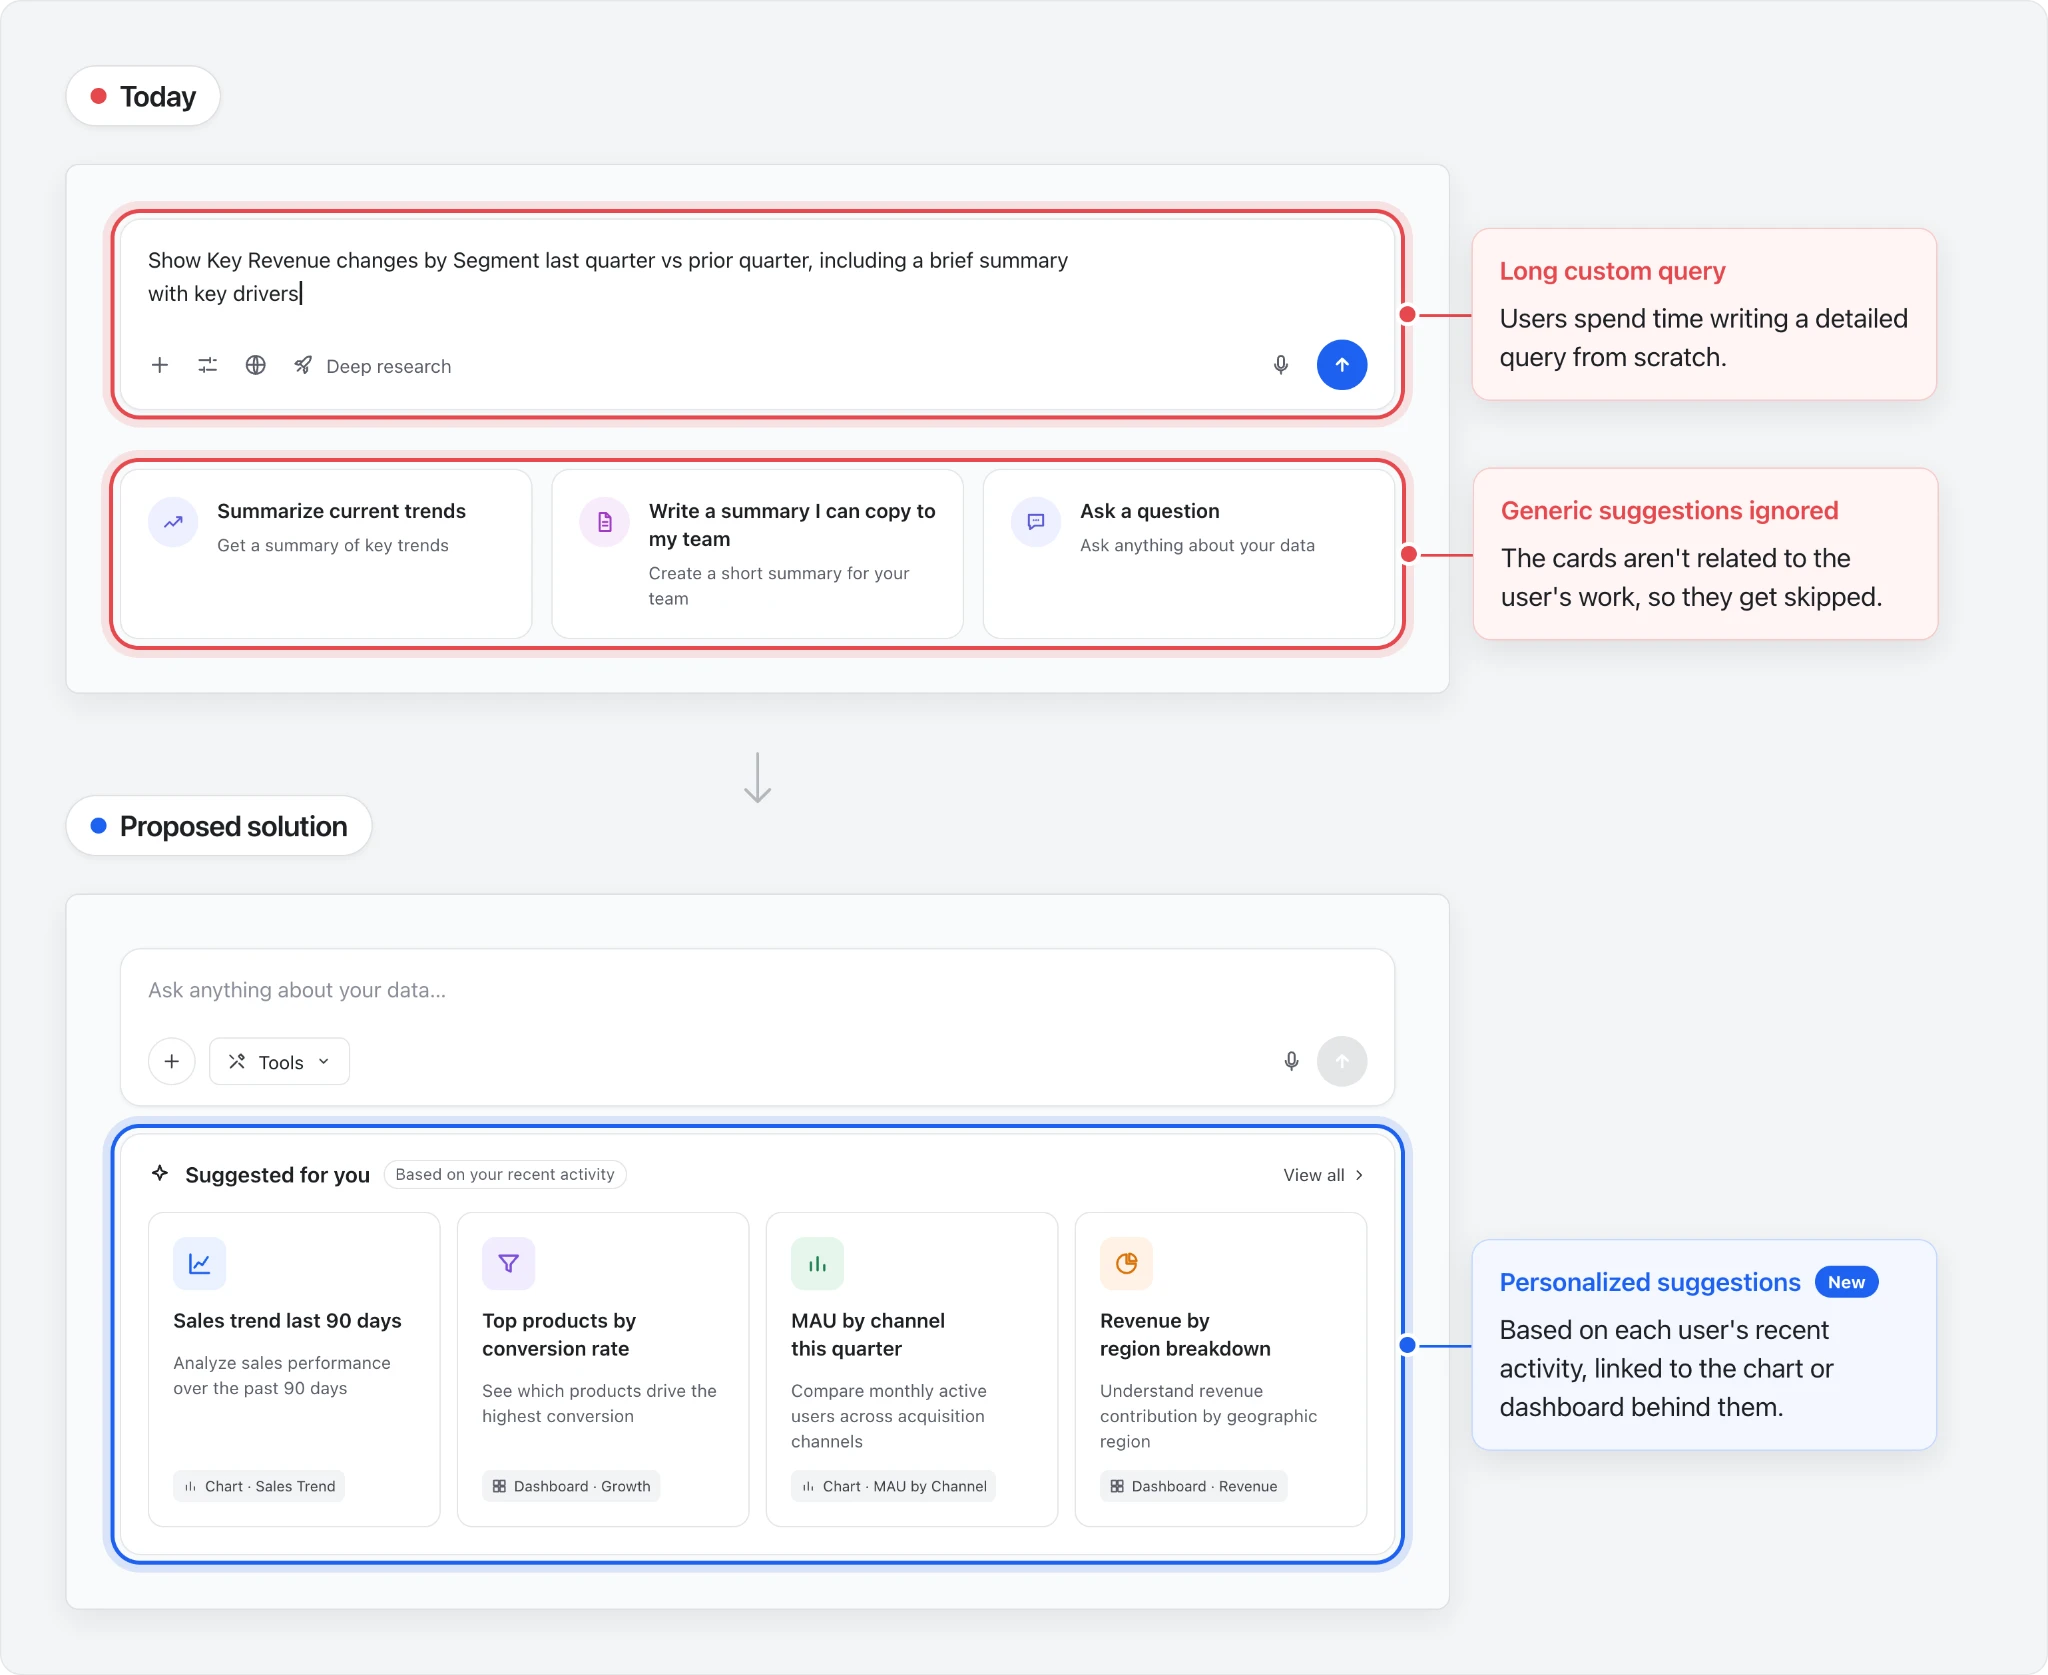
Nel risultato sperimentale, i messaggi inviati tramite le schede di suggerimento sono aumentati del 160 % rispetto al gruppo di controllo dopo un solo giorno. Eric Carlson, Senior Principal AI Engineer, commenta: “È un ottimo esempio di come piccole modifiche, spesso ignorate, possano incrementare l’adozione di funzionalità in modi inattesi.”
Scegliere il modello OpenAI giusto per ogni compito
Le attività di Wave hanno requisiti diversi. Un’indagine approfondita richiede forte capacità di ragionamento e conclusioni ben supportate; un piccolo controllo ripetuto centinaia di volte deve essere veloce ed economico. Amplitude valuta qualità, latenza e costo per ogni tipo di compito, assegnando il modello più adatto.
“OpenAI ci ha fornito sia modelli di ragionamento potenti sia modelli più piccoli e veloci, così possiamo bilanciare qualità, latenza e costo di inferenza nel prodotto.” — Spenser Skates, CEO di Amplitude
Per l’Opportunity Investigator, Amplitude ha confrontato diversi modelli su cinque criteri (correlazione, falsi positivi, feedback, resilienza a errori di tool, coerenza con le evidenze). GPT‑6.1 Sol ha ottenuto 4,06 su 5, superando i tre modelli alternativi (3,62; 3,52; 2,94) e ha registrato il tempo medio più breve: 54 minuti.
Nel Data Science Agent, GPT‑6.1 Sol ha totalizzato 67,5 su 100, leggermente inferiore a un modello concorrente (69,3), ma con un costo medio per dispatch di 1,28 $, contro 2,63 $ del concorrente. Inoltre, ha eccelso in conformità al contratto degli strumenti, stima dell’incertezza e fondamento delle evidenze.
Valutazione del Data Science Agent GPT‑6.1 Sol
- Precisione delle conclusioni: 4,06/5
- Tempo medio di indagine: 54 min
- Costo medio per dispatch: 1,28 $
- Conformità al tool‑contract: superiore al concorrente
- Gestione dell’incertezza: punteggio più alto
Per i compiti ad alto volume, come la scansione di codice e piccoli controlli, Amplitude utilizza GPT‑6 Luna, mantenendo latenza e costi contenuti. La suddivisione del lavoro tra agenti specialisti permette di riservare i modelli più costosi solo alle attività che ne traggono il massimo beneficio.
Valutazione del modello di immagine GPT‑Image‑2.5 Flare
Per la generazione di wireframe e mock‑up, il modello di generazione immagine di OpenAI ha ottenuto 80,3 su 100, contro 63,9 per un modello concorrente. La valutazione ha coperto:
- Qualità della comunicazione
- Fedeltà al prodotto
- Adesione alle istruzioni
- Leggibilità di testo e UI
- Coerenza visiva su 15 opportunità
Le squadre mantengono il controllo su ciò che viene rilasciato
Clienti di diversi settori stanno già usando Wave in beta per identificare e lanciare miglioramenti. Wave analizza dati di sessione e analytics, poi propone una correzione, un piano tecnico e criteri di accettazione.
Da quel punto, le squadre decidono il livello di automazione. La maggior parte invia le correzioni di bug direttamente agli agenti di codifica, mentre le nuove funzionalità o i progetti più ambiziosi passano per una revisione umana.
Per le modifiche che arrivano al lancio, il percorso dalla scoperta all’esecuzione è estremamente breve: tra gli esperimenti, i flag e le guide lanciati dai clienti, uno su quattro è stato messo in produzione lo stesso giorno in cui Wave ha individuato l’opportunità, la metà entro quattro giorni e due su tre entro una settimana.
Queste curve sono interpolazioni basate sui milestone forniti; servono a illustrare la tendenza, non a descrivere osservazioni individuali.
Cosa ci riserva il futuro
“La nostra ambizione con OpenAI è rendere i prodotti auto‑miglioranti, come le aziende costruiscono software,” afferma Spenser Skates. Man mano che i modelli di OpenAI migliorano nel ragionamento e nella programmazione, le squadre potranno delegare più indagini e implementazioni agli agenti, accelerando il ciclo di consegna e migliorando l’esperienza utente.
Amplitude sta già osservando questi effetti: gli agenti trovano e aiutano a consegnare miglioramenti nel prodotto interno, mentre il team si concentra su altre priorità. “Penso che le squadre saranno sorprese da quanto possano realizzare quando il loro software lavora al loro fianco per rendere il prodotto migliore.”
Iscriviti agli aggiornamenti OpenAI for Business
Rimani aggiornato su novità di prodotto, guide pratiche, eventi imminenti e molto altro.