Introduzione
Questo testo è un compagno autonomo della serie Enterprise Document Intelligence, la cui tesi centrale è che i sistemi RAG (retrieval‑augmented generation) amplificano l’esperto, senza sostituirlo. L’architettura si basa su quattro mattoni fondamentali – parsing del documento, parsing della domanda, recupero e generazione – ciascuno dei quali emette dati tipizzati che confluiscono in un’unica chiamata a un LLM. La pratica di assemblare tutti questi componenti è stata recentemente denominata context engineering.
Il focus di questo articolo è il caso di documento singolo; le estensioni a corpus, conversazioni e chiamate a tool saranno trattate in lavori successivi.
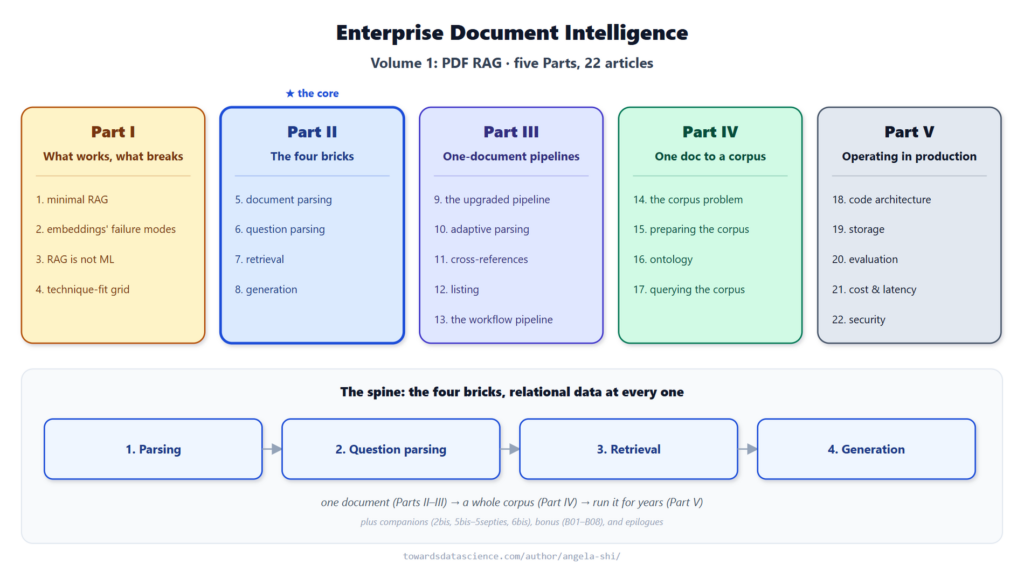
Figura: dove questo articolo si colloca nella serie – Articolo 7bis (context engineering), l’immagine è di proprietà dell’autore.
Risorse operative
📓 Notebook eseguibili sono disponibili su GitHub: doc‑intel/notebooks-vol1.
Figura: repository pubblico dei notebook – immagine dell’autore.
Il flusso completo della pipeline RAG
Una volta costruiti i quattro mattoni di un RAG su documento singolo, l’assemblaggio è definito. Il parsing genera tabelle relazionali; il parsing della domanda produce un oggetto ParsedQuestion tipizzato; il recupero restituisce un sottoinsieme filtrato di righe con un audit dettagliato; la generazione crea una risposta Pydantic con citazioni di evidenza. Tutti questi elementi si combinano in una sola chiamata LLM, con un system prompt fisso e un contenuto utente composto dagli output dei mattoni precedenti.
Da “prompt engineering” a “context engineering”
Nel giugno 2025 Tobi Lütke ha twittato che il termine “prompt engineering” fosse impreciso e ha proposto context engineering come nuova definizione: “l’arte di fornire tutto il contesto necessario affinché il compito sia plausibilmente risolvibile dal LLM”. Un giorno dopo, Andrej Karpathy lo ha convalidato, definendolo “l’arte delicata e la scienza di riempire la finestra di contesto con le informazioni giuste per il passo successivo”. In pochi mesi il concetto è comparso sulla copertina di un libro O’Reilly ed è stato formalizzato in una tassonomia da LangChain.
1. Il nome e la sua estensione
In passato, prompt engineering indicava due attività correlate: ottimizzare la formulazione di un singolo prompt per ottenere un comportamento migliore e creare esempi (few‑shot) affinché il modello apprendesse il formato di output desiderato. Entrambe le attività erano limitate a un blocco di testo inviato in una chiamata.
Il context engineering ingloba tutto ciò che viene inserito nella finestra di contesto del modello per una chiamata:
- Il system prompt (ruolo, regole, esempi).
- I documenti o le righe recuperate.
- La cronologia della conversazione, se presente.
- Le definizioni dei tool e i loro output.
- Memoria, scratchpad, stato dell’agente.
- Metadati strutturati sul documento, sul corpus, sul progetto.
- L’input effettivo dell’utente.
In un agente a lungo termine che effettua decine di chiamate, il prompt occupa solo una delle sei‑otto “slot” disponibili; gli altri slot provengono da recuperatori, tool, store di memoria o lookup di profili. La disciplina si sposta da “cosa scrivere nel prompt” a “cosa assemblare nel contesto, da dove proviene ogni pezzo e come mantenerne la stabilità tra le chiamate”.
2. Ogni mattone emette contesto tipizzato
Lo schema illustrato nella figura successiva riassume i quattro mattoni e i loro output tipizzati. I nomi nelle caselle corrispondono ai campi reali delle classi Pydantic e dei DataFrame prodotti dal codice.
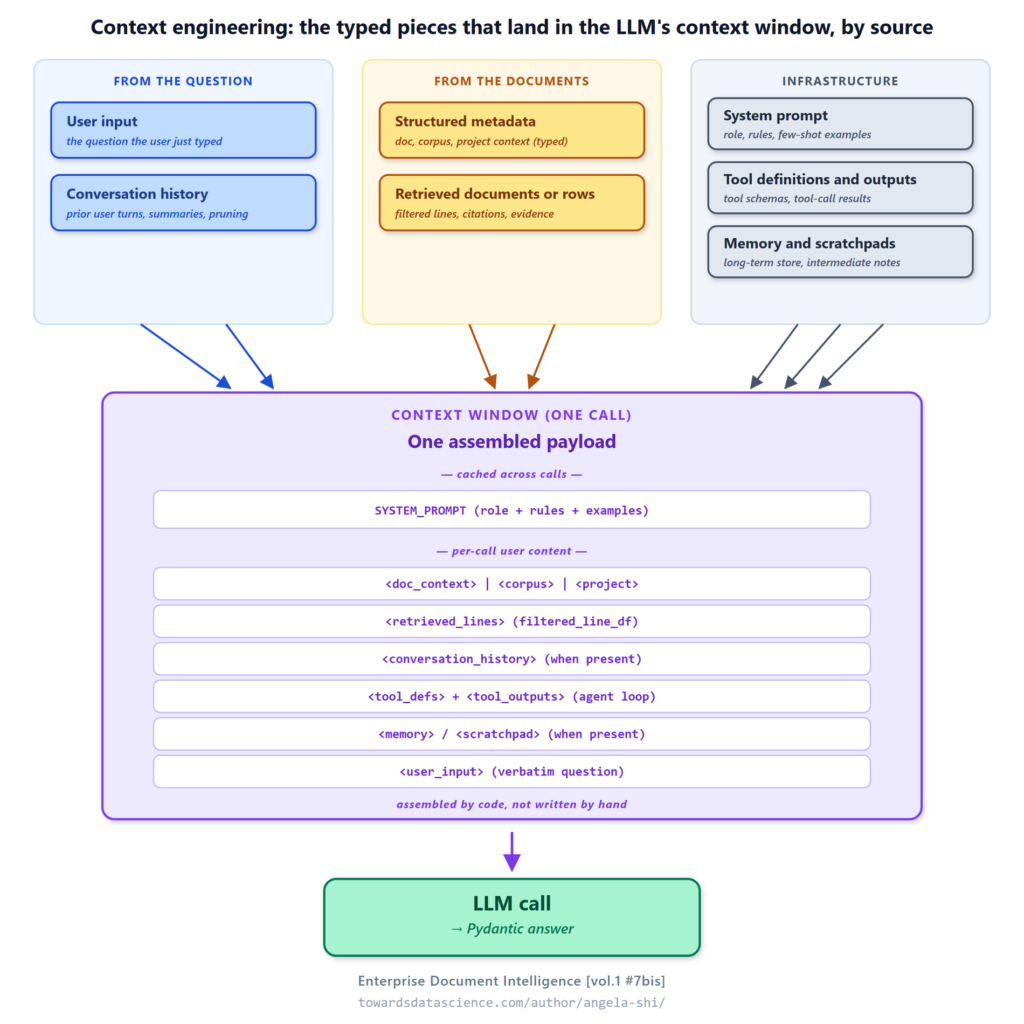
Figura: sette mattoni tipizzati che alimentano la finestra di contesto LLM, raggruppati per sorgente – immagine dell’autore.
Parsing del documento
Il parsing genera tabelle relazionali e un dizionario di sintesi:
line_df: una riga per ogni linea del documento, con coordinate di bounding box.page_df: una riga per ogni pagina, includendo tipo di pagina e conteggio colonne.toc_df: voci di indice con pagina di inizio e profondità.image_df: immagini incorporate con pHash e metadati.parsingsummary: sintesi a livello di documento con campidoctype,npages,typicalfields,summarye campi di meccanica.
Il mattone di recupero utilizza le tabelle per‑riga, mentre il parsing della domanda consuma il sotto‑insieme semantico di parsing_summary tramite DocContext.
Parsing della domanda
Il risultato è un oggetto ParsedQuestion con campi rigorosamente tipizzati:
keywords: lista breve di frasi nominali contenenti contenuti